- エコシステム
- クイック ファインダー


インテル® Core™ Series 3 プロセッサー(コードネーム:Wildcat Lake)は、インテル Core Ultra Series 3 プロセッサーで導入された最新のプロセッサーテクノロジーを、低消費電力およびエントリーレベルの x86ベース組込みコンピューティングでも利用できるようにします。 第一に、パフォーマンスとコンピューティング密度の飛躍的な向上を実現するために、画期的な Intel 18Aプロセス技術を採用し、最大2つのパフォーマンスコア(Pコア)と4つの低電力効率コア(LP Eコア)を搭載しています。 次に、専用のニューラル・プロセッシング・ユニット(NPU)を搭載した、初の インテル Core プロセッサーになります。 さらに、この高度にインテグレートされたシステム・オン・チップ(SoC)は、消費電力が 10~35Wで設定可能な汎用GPU(GPGPU)として、AIアプリケーションを高速化する インテル® Xe3 グラフィックスも内蔵しています。
すぐに使用できるアプリケーションレディの 「conga-TC300」 COM Express Compact モジュールに搭載されたこの新世代プロセッサーは、インダストリアル オートメーションやロボティクス、医療、輸送、スマートシティ、小売システムといった分野において、ローカルAI機能を導入するためのコスト効率に優れたプラットフォームを提供します。
エッジAIへの効率的なアップグレード パス
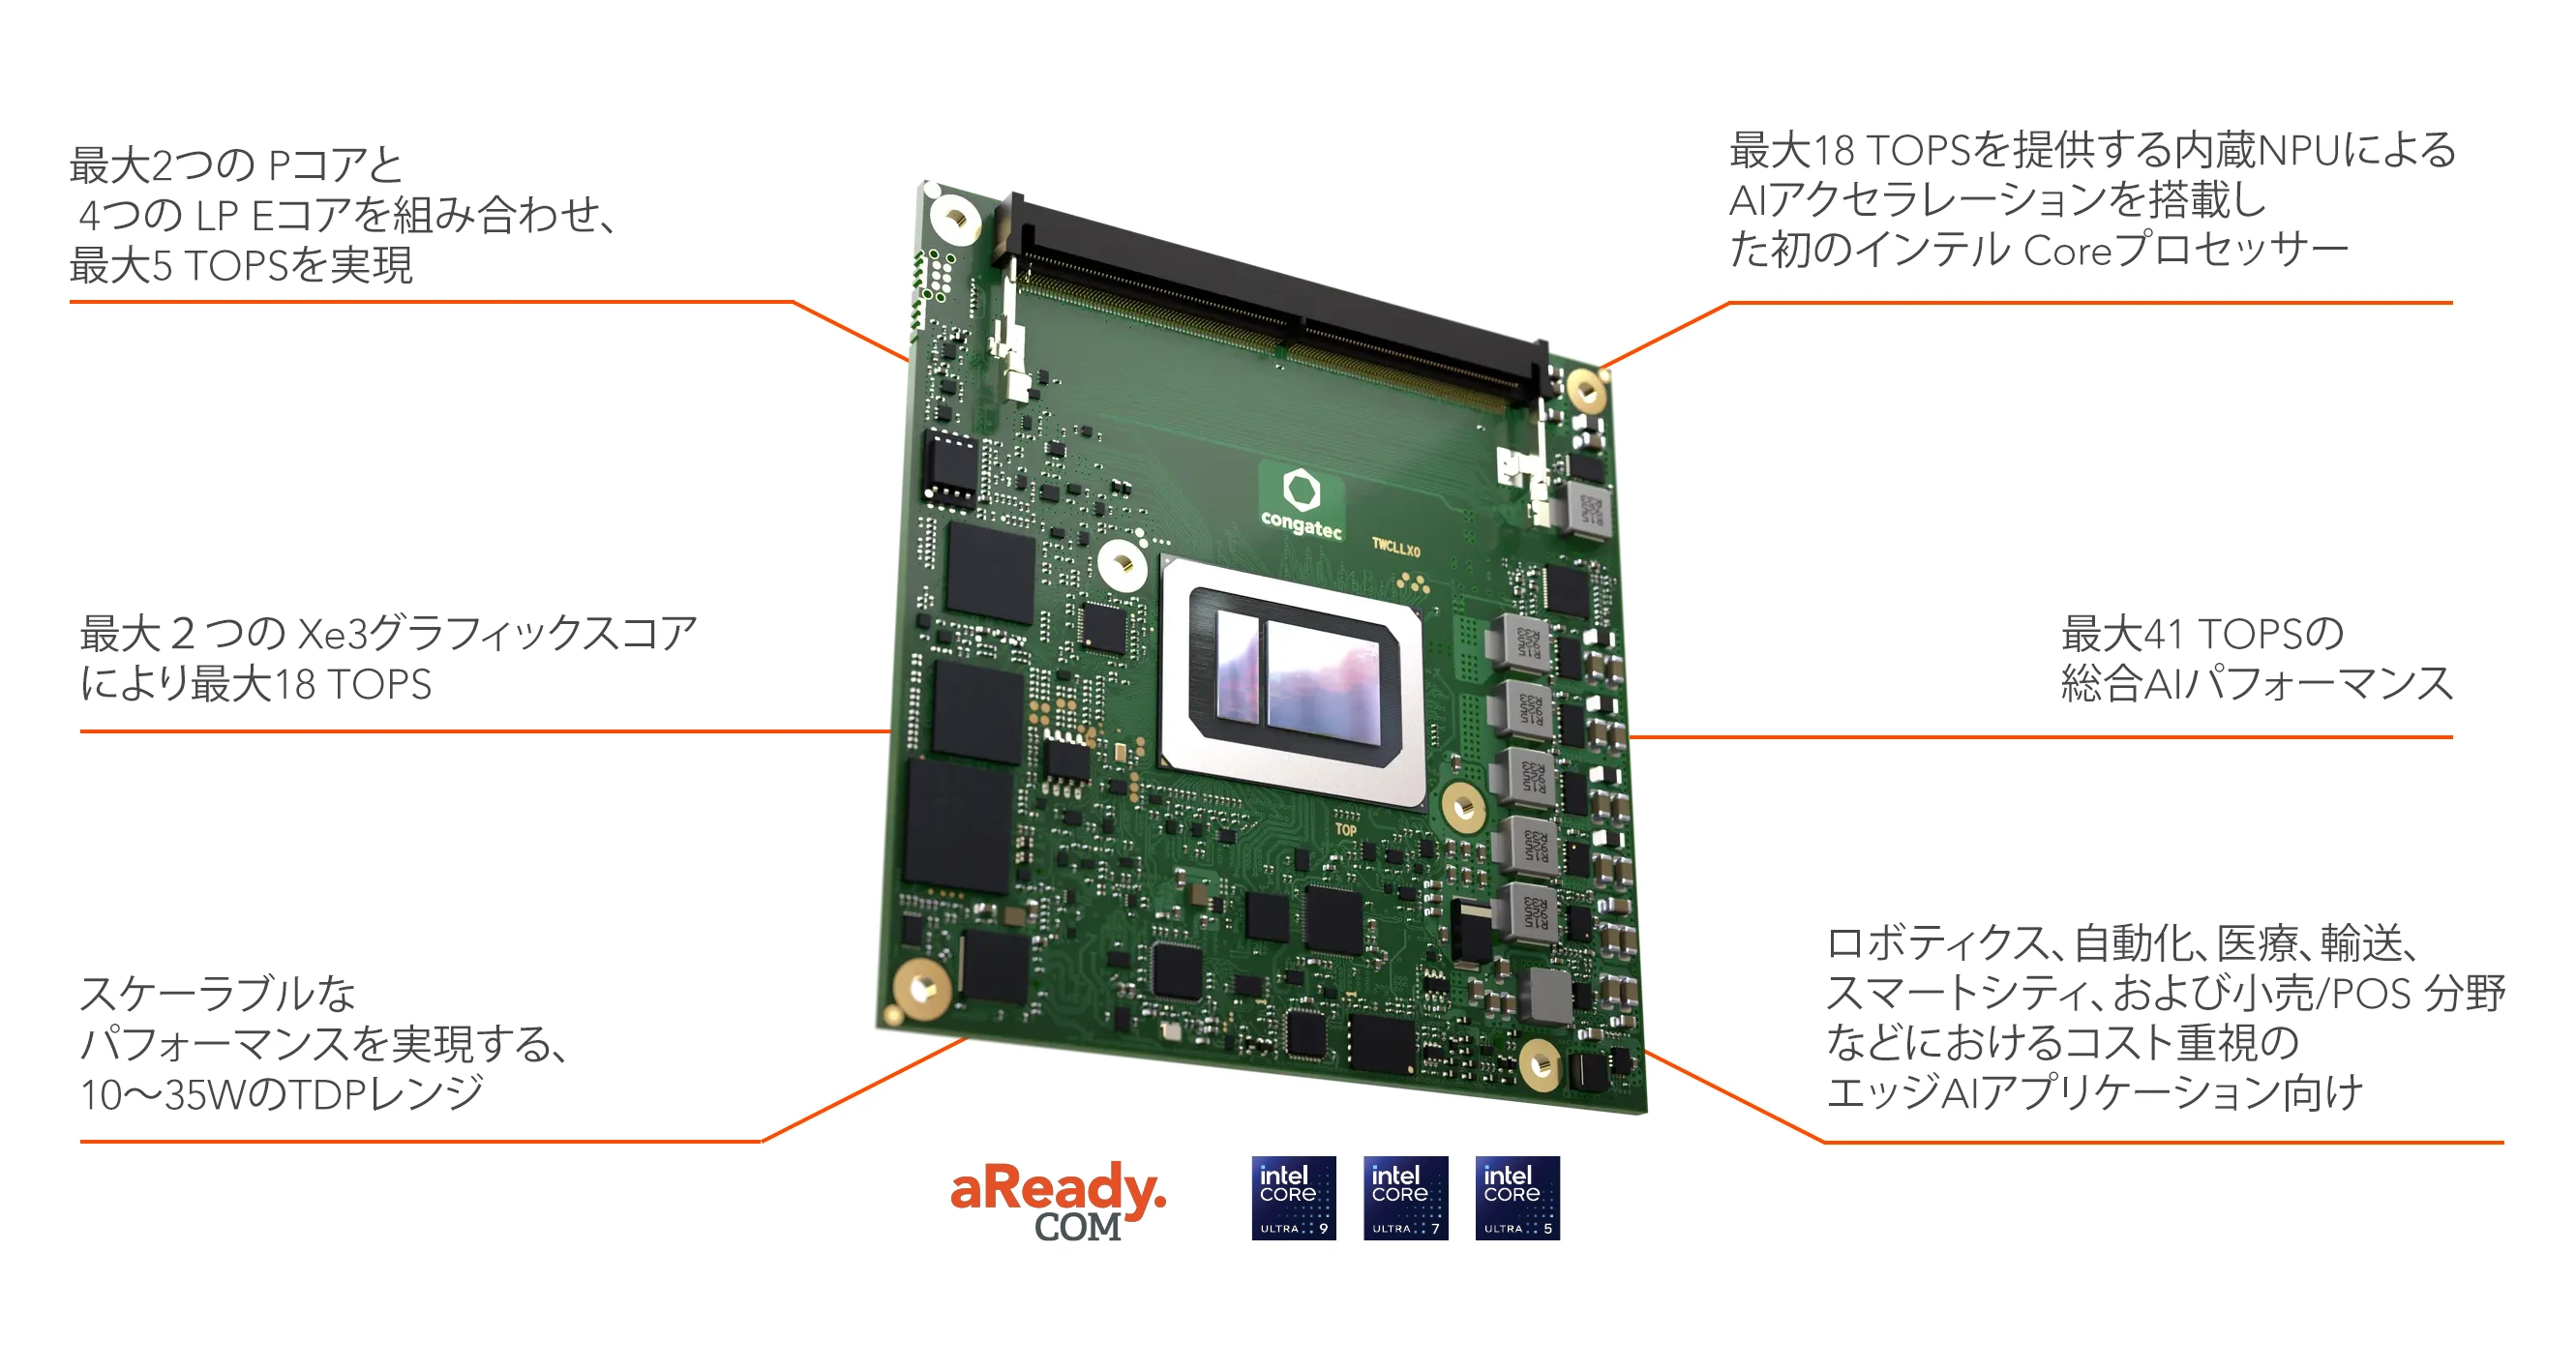
インテル® Core™ Series 3 プロセッサーは、従来のIntel Atom® やCeleron® プロセッサー プラットフォームをベースとした組込みアプリケーションに対して実用的な移行パスを提供し、低消費電力の x86プラットフォームに専用のAIアクセラレーション機能を追加します。 このヘテロジニアス プロセッサー アーキテクチャーは、最大2つのパフォーマンスコア(Pコア)と4つの低電力効率コア(LP Eコア)を内蔵しています。 最大6コア構成のアーキテクチャーにより、CPUは最大5 TOPSの処理能力を提供します。
インテル® Core™ Series 3 プロセッサーは、電力効率に優れたAI推論向けに最大18 TOPSの性能を発揮する専用NPUを搭載しています。 このNPUは、物体検出や画像分類、異常検知、音声/ジェスチャー認識といった、継続的に実行されるAIワークロードに最適化されています。
最大 2 つの インテル® Xe3 グラフィックス コアにより、さらに 18 TOPS が追加されます。 内蔵のグラフィックス コアは、グラフィカル ユーザーインターフェースや複数のディスプレイのサポートに加え、画像の前処理やコンピューター ビジョン、GPGPU ベースの AI処理などの高度な並列ワークロードを高速化します。
CPU と インテル® Xe3 グラフィックス、および専用NPUを組み合わせることで conga-TC300 は、最大41 TOPSの総合AIパフォーマンスを実現します。 このモジュールは最大10年間の供給を予定しており、低消費電力かつ軽量なAIアプリケーションに新たなAI機能を追加する、信頼できる移行パスを提供します。
機器メーカーはモジュールを conga-TC300 に交換するだけで、既存のアプリケーションにAI機能を追加することができます。 ハードウェアを再設計する必要はなく、無人搬送車(AGV)や自律走行搬送ロボット(AMR)、インテリジェントなマシンコントロール、HMI、患者データ管理システム(PDMS)、監視システム、チェックイン/チェックアウト端末といったアプリケーションを、ソフトウェアの更新のみでアップグレードすることが可能です。
AIの活用例としては、ローカルでの音声/ジェスチャーによるコントロールや、AIによる物体認識と識別、大規模言語モデル(LLM)を活用した対話機能などが挙げられます。 そのため conga-TC300 は、コスト効率とエネルギー効率に優れたAI機能を付加して、既存の機器の付加価値を高めたいと考えている開発者にとって最適なプラットフォームとなります。
コストや消費電力に制約のあるシステム向けの設計
インテル® Core™ Series 3 プロセッサーのベースTDPは 15W ですが、10~35W のレンジで設定することができるため、開発者は機器のバリエーションに応じて、演算性能やAIアクセラレーション、熱要件などのバランスを最適化することができます。 統合型アーキテクチャーを採用しているため、追加のアクセラレーター ハードウェアが不要になります。 そのため、システムの複雑さや消費電力、冷却要件、キャリアボードのスペース、および部品コスト(BOM)を低減することができます。
conga-TC300 モジュールは、インテル® Core™ Series 3 プロセッサー テクノロジーを、標準化されたCOM Express Compact フォームファクターで提供します。 機器メーカーは、モジュール式かつスケーラブルなシステム アーキテクチャーを維持しつつ、モジュールを特定のアプリケーション向けのキャリアボードにインテグレーションすることが可能です。 このアプローチは、異なるパフォーマンスレベルが求められる製品ファミリーの開発に特に最適で、キャリアボードの設計やソフトウェア環境、I/Oコンセプトを共通化することができます。
ファクト、機能、利点
| ファクト | 機能 | 利点 |
|---|---|---|
| ヘテロジニアス コンピューティング アーキテクチャー | 2つのパフォーマンスコア、4つの低電力効率コア、インテル® Xe3グラフィックス、および専用NPUを単一のSoCに統合 | 既存アプリケーションの機能と性能を向上させるために、常に最適なプロセッシング ユニットを活用してアプリケーション処理やグラフィックス、AI推論を単一のプラットフォーム上で効率的に統合することで、個別のアクセラレーター ハードウェアを不要にします。 |
| ハイブリッド CPU アーキテクチャー | 6つの CPUコアは 2つのPコアと 4つのLP Eコアで構成され、Pコアのターボ周波数は最大4.8GHz | コントロールや通信、および組込みアプリケーションのワークロードに対し、応答性の高いシングルスレッド パフォーマンスと効率的なバックグラウンド処理を提供します。 |
| 内蔵インテル® Xe3 グラフィックス | 最大2つグラフィックスコアによる最大18 TOPSのAIアクセラレーション | ディスクリートGPUを必要とせずに、グラフィカル・ユーザー・インターフェース(GUI)や画像の前処理、コンピュータービジョン、および並列GPGPUワークロードを高速化します。 |
| 専用NPU | 最大18 TOPSのAI処理性能 | 高いエネルギー効率で継続的なAIワークロードを実行し、CPUとグラフィックスコアの負荷を低減します。 |
| 高速システムメモリーと大容量ストレージ | 最大64GBのDDR5メモリー(最大6400 MT/s)、オプションでインバンドECC(IBECC)に対応。 オプションで最大512GB オンボードUFS 3.1ストレージ。 | 大量のデータを扱う組込みワークロードや AIワークロードをサポートし、オプションのエラー訂正機能によってシステムの整合性を向上させます。 外部ストレージ デバイスを不要にし、コンパクトなシステム設計を簡素化します。 |
| インダストリアル ネットワーク | オプションとして、自由に構成可能な最大8レーンの PCIeレーンや、オプションで Time-Sensitive Networking(TSN)に対応する 2.5ギガビット イーサネット、およびTime-Coordinated Computing(TCC)をサポート | 自由に構成可能な PCIeレーンにより、キャリアボード上に追加の PCIeスイッチを必要とすることなく、イーサネット コントローラーやフィールドバス アダプター、無線モジュール、その他のレーン数が少ないペリフェラルをサポートします。 ギガビット イーサネットは、インダストリアル オートメーションやロボティクス、およびリアルタイム エッジアプリケーションにおいて、決定論的かつ時刻同期に対応した通信を実現します。 |
| 設定可能なプロセッサー電力 | プロセッサーのベースパワーは 15 Wで、10~35 Wのレンジで設定可能 | ファンレスやアクティブ冷却、あるいは特定アプリケーション向けのシステム設計において、開発者がパフォーマンスと冷却を最適化できるようにします。 |
| さまざまなディスプレイおよびペリフェラル インターフェース | 最大2x DDI、1x LVDS または eDP、最大2x USB4、4x USB 3.2、4x USB 2.0、2x SATA、2x UART、GPIO、GP SPI、eSPI、SM Bus、HDA、および I2Cインターフェース | 産業用HMIや医療用ディスプレイ、オペレーター端末、およびネット接続されたエッジデバイスの導入を簡素化します。 |
代表的なアプリケーション

ロボティクス
無人搬送車(AGV)や自律走行搬送ロボット(AMR)、およびサービスロボットには、ナビゲーションと認識、通信、制御といった機能の組み合わせが求められます。 インテル® Core™ Series 3 プロセッサーは、センサーデータの処理や、物体の検出と識別、音声やジェスチャーによる指示の解釈、そしてグラフィカル・ユーザー・インターフェース(GUI)に必要な専用のリソースを提供します。

インダストリアル オートメーション
マシン コントローラーや、外観および品質検査システムは、制御ロジックや画像の前処理、AI推論を、1つのコンパクトなプラットフォーム上で実行することができます。 CPUがアプリケーションやコントロールの処理を担う一方、グラフィックスコアが画像処理を高速化します。 また、NPUは不良の検出や光学式文字認識(OCR)、予知保全のためのAIモデルを効率的に実行します。

メディカル テクノロジー
患者データ管理システムや診断機器、および医療用ユーザーインターフェースでは、ローカルAIを活用してデータの分析や臨床ワークフローのサポートをおこなうことが可能で、機密情報を継続的にクラウドへ転送する必要はありません。 内蔵されたNPUが電力効率に優れた推論処理を実現する一方で、CPUとグラフィックスコアは、アプリケーション処理やビジュアライゼーション、および機器のネット接続に必要なパフォーマンスを提供します。

交通
旅客案内システムや運行管理端末、車載ゲートウェイ、およびモニタリング システムでは、グラフィックスや通信機能、AI処理を単一のモジュールに統合することが可能です。 想定される機能には、ドライバーおよび乗客とのインタラクションや物体認識、音声コントロール、状態モニター、さらにはカメラやセンサーデータのローカル解析などが含まれます。

スマートシティ
ネットワークカメラや入退室管理システム、インテリジェント インフラストラクチャーでは、映像やセンサーのデータをエッジにおいて直接処理することが可能です。 専用のNPUが継続的な推論ワークロードをサポートする一方、Xe3 グラフィックスが画像の前処理やコンピュータービジョンのパイプラインを高速化します。 ローカルでの処理は、ネットワークトラフィックの削減や応答時間の短縮を実現し、システムによる機密性の高い運用データの管理を強化します。

小売り/POS
セルフサービス端末やチェックイン/チェックアウト システム、デジタルキオスク、スマート自動販売機などに、物体認識や音声対話、ジェスチャーによるコントロール、LLM(大規模言語モデル)ベースの対話といった機能を追加することができます。 AIアクセラレーションやグラフィックス、ディスプレイ インターフェース、インテグレートされた接続性を組み合わせることで、個別のAIアクセラレーターを必要とせずに、コンパクトかつ応答性が高いシステムを実現することができます。